DeepSeek必读指南
发布于
2025-02-04
时间线
下面是DeepSeek事件的时间线,一口气看它在短短时间内掀起了多少惊涛骇浪。
开源了大语言模型DeepSeek V3,专注于数学、编码和中文任务,性能对标GPT 4o等产品,同时在效率方法上有所突破,促使人们重新评估人工智能模型开发的既定方法。
2024年12月27日
开源了大推理模型DeepSeek R1,性能直接对标世界顶尖模型OpenAI o1,且公开推理过程和原理,引起了全世界科技媒体的关注。何况还是在受限的硬件上做的工作,简直颠覆世人的认知。
2025年1月20日
在国外社媒上爆火,热度一路狂飙。《黑神话:悟空》的创造者冯骥认为,DeepSeek可能是个国运级别的科技成果,号召大家赶紧用、使劲用,让AI逐渐变成生活中的水和电。
2025年1月24日
DeepSeek在美区霸榜,导致欧美科技股市值蒸发,英伟达市值单日跌幅达17%,蒸发近6000亿美元,创下美股史上公司最大单日跌幅纪录。特朗普表示这是给美国人工智能行业敲响的「警钟」。
2025年1月27日
DeepSeek遭到大规模恶意攻击,暂时限制了+86手机号以外的注册方式。相关网络安全专家透露,DeepSeek近一个月以来一直遭受大量攻击,面临着前所未有的安全考验。
2025年1月28日
英伟达称DeepSeek R1推理能力强、效率高、准确性领先,宣布将DeepSeek R1集成到自家的平台。接着有美国官员认为,DeepSeek「蒸馏」技术对美国构成了「偷窃」威胁,可能导致信息泄露。
2025年1月30日
DeepSeek R1模型发布第五天,日活就超过了当初ChatGPT上线同期的日活,第15天达到了259万日活,第18天达到了1500万日活,而ChatGPT达到同样的日活,花了244天。
这半个月也让我有一种见证历史的感觉,也许将来我们回顾历史时,会认为这是一个转折点。就像当初计算机的出现让世界进入了数字时代,又或者互联网改变了一切。
DeepSeek用创新挑战霸权,用开源改写规则,从此,小公司也能玩转顶级AI,全世界的聪明脑袋都能在这个基础上继续创新,这才是真正的技术自信和科技平权。
DeepSeek V3
这里我们将向非技术人员讲解DeepSeek到底做对了什么,确保中学生都能听懂。
DeepSeek V3之所以这么成功,核心一句话:穷人家的孩子早当家!
我们知道,DeepSeek这样的大语言模型是需要大量算力来训练的。英伟达卖给美国的都是H100,而卖给中国的是H800。别看版本号高了,其实是极大限制了性能和带宽,目的就是要锁死中国的AI技术发展。别抱怨,2023年底开始,因为美国政府的限制,英伟达连H800都不卖给中国了。
下面这个是DeepSeek的总体架构图:
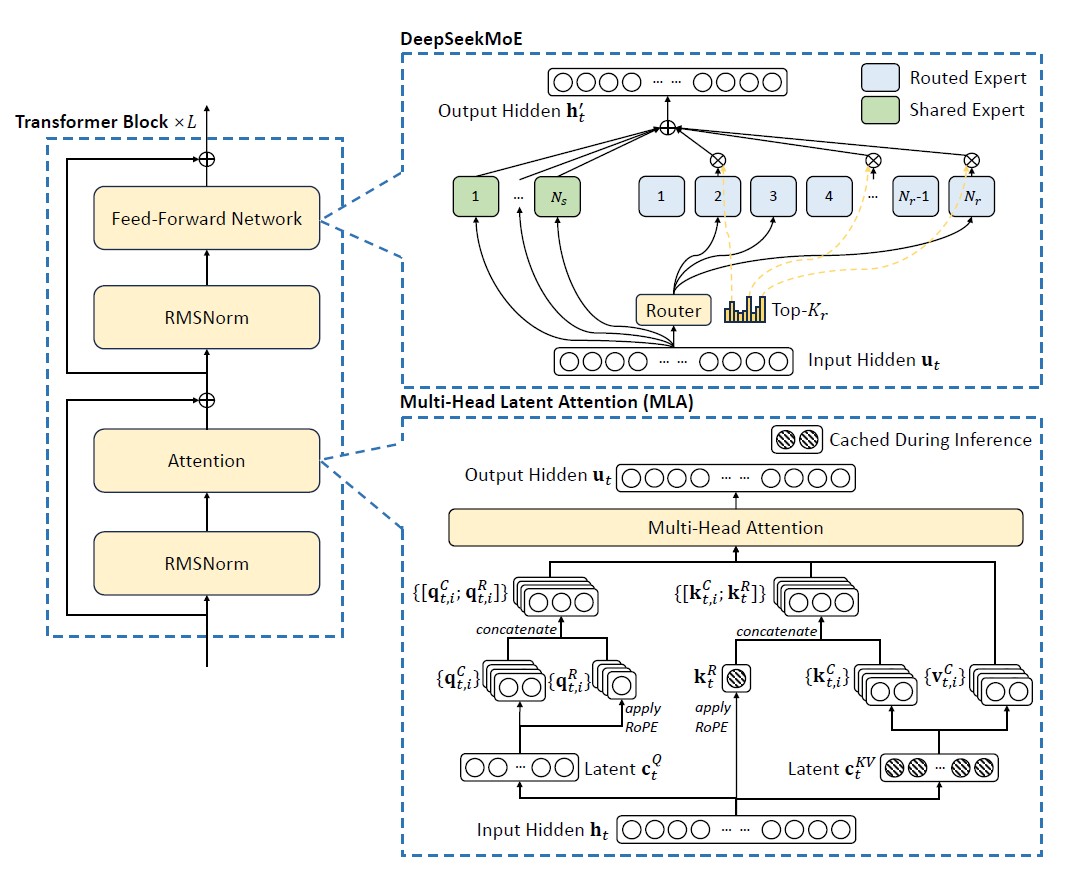
架构图中:
- 左侧表示的是传统的大语言模型。
- 右边是DeepSeek V3的两大创新:混合专家和多头低秩注意力。
混合专家(MoE)听起来很高深,我给你打个比方你就明白了。
好几十年前,中国的医生是全科的,病人住院时,是一个医生从头到尾负责到底的,保管治好。这样全能的医生培养起来没个十几年功夫是不可能的,但是,医生照顾一种疾病的病人时,其他任何专业知识都用不上,造成了巨大的浪费。
这就是LLaMa这样的传统模型的窘境。
而现代的医院呢会培养不同科目的医生,内分泌、肾脏、心脏等等,然后在医院设置预诊,引导病人去不同的科室。这样的好处就是培养医生的成本大大下降,而且不同一个病人只会劳烦一种科目的医生,医生的执行效率也有很大提升。
这就是混合专家(MoE)的原理。虽然并非原创,DeepSeek在早期的混合专家架构上做了很多创新,可以更高效地训练和配置医生,把性价比做到极致!
多头低秩注意力(MLA)也不难理解。为了更好地理解文本,大模型会通过多个视角关注句子中的不同重点信息,代价呢就是非常占用内存。DeepSeek通过压缩降低了存储要求,极致压缩了成本。
不仅如此,DeepSeek V3还实现了:
- 低精度训练(FP8)
- 并行训练算法DualPipe
- 高效的跨节点通信
这一切就是要突破H800的限制,实现极致的性价比!
诚然,很多工作是改良而不是改革,但是在艰苦环境中不屈不挠,向智力要生产力,所以才做出了极具性价比的人工智能模型,单单定价就让糖水里长大的OpenAI大跌眼镜。
DeepSeek R1
现在我们来讲解DeepSeek R1。
DeepSeek R1是一个大推理模型,是在大语言模型DeepSeek V3础上进一步发展,着重强化推理能力的一类人工智能模型。
如果DeepSeek V3是「文科状元」的话,那么DeepSeek R1就是「理科状元」了。
可以通过卡尼曼在《思考,快与慢》中形容两种思考模式来理解:
| 属性 | 系统1 | 系统2 |
|---|---|---|
| 定义 | 快速的直觉性思维 | 缓慢的审慎性思维 |
| 特性 | 自动的 不费力的 直觉的 情绪化的 | 有意识 的费力的 受控制的 逻辑性的 |
| 示例 | 识别面孔 重复基本事实 对某事做出反应 | 解决数学问题 规划详细议程 做出深思熟虑的决定 |
| 模型 | OpenAI GPT4o DeepSeek V3 | OpenAI o1 DeepSeek R1 |
DeepSeek V3本质上是「想到什么说什么的小孩」:虽然回答很快,但是对于数学、编程、科学这些就懒得动脑筋了,成绩自然就不够看了。
DeepSeek R1其实是「说话之前动脑思考的青年人」,这样在解决数学、逻辑、编程等方面就获得了接近甚至超越人的能力。
OpenAI是怎么训练推理能力的呢?
回想一下学校里是怎么教数学的:
| 阶段 | 数学系学生 | 大推理模型 |
|---|---|---|
| 预训练 | 课前预习,了解书本中的基础概念和思想。不预习就敢去上课的还是需要实力的。 | 从海量文本数据中学习背景知识和模式。 |
| 示例 | 课上老师讲解经典例题,展示专家是如何解决问题的。这些都是可以模仿的示例,一定要弄清楚。 | OpenAI聘请了顶级的数学家和程序员来标记思考过程,效果虽然好,但是就很费老师。 |
| 模型 | 是给学生的课后练习题,通常不包含解答。学生必须参考经典例题,通过尝试多种方法才能找到正确答案。 | OpenAI是老师给出奖惩,而DeepSeek让多个学生自学并从中选出最好的思路给与奖励,无师自通。 |
因为没钱请数学和编程名师,DeepSeek索性就自学数学和编程,从中找出做题最好的学生给与奖励。没想到,通过这样的强化学习,最终悟出了解题的精髓!
这就是DeepSeek R1 Zero天赋异禀的学神无师自通的故事,让全世界大开眼界!
相对的,OpenAI对于推理的原理和结果是敝帚自珍束之高阁,而DeepSeek直接通过论文与全世界分享。
以前欧美总有人戴带着有色眼镜看中国,认为中国人只会模仿不会创新,但是DeepSeek R1通过开源共享和创新精神让全世界感受到了中国的力量!
结束语
十九世纪末的欧洲,虽然工业化快速发展、科技日新月异,但同时也带来了贫富差距加大等问题。这时,尼采喊出「那些杀不死你的,终将使你变得更强大」这句振聋发聩的名言。
虽然人工智能这波浪潮汹涌,我们也要学习DeepSeek的精神,勇敢面对困境,追求内心的梦想。
目录
